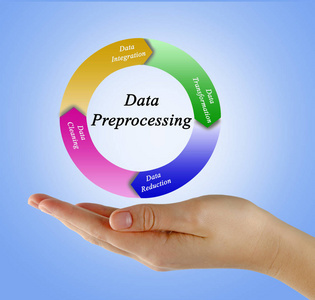
在数据驱动的商业决策中,产品订单的数据处理是需求预测的基石。第十一届泰迪杯B题的第二大问聚焦于产品订单的数据分析与需求预测,而数据处理环节直接决定了后续模型的精度与可靠性。本文将围绕该问的数据处理步骤展开,包括数据清洗、缺失值处理、异常值检测、特征工程与数据整合,为需求预测提供高质量输入。
一、数据清洗:剔除冗余与噪声
原始订单数据常包含重复记录、无效字段或格式不一致的信息。需检查订单编号、产品ID、客户ID等关键字段的唯一性,删除完全重复的行。统一日期格式(如转换为YYYY-MM-DD)、数值格式(如金额保留两位小数),并剔除与业务逻辑明显矛盾的记录(如订单数量为负数、发货日期早于下单日期)。
二、缺失值处理:填补与舍弃的权衡
缺失值可能在客户信息、产品属性或订单金额中出现。对于关键字段(如订单日期、产品ID)缺失的记录,建议直接删除;对于非关键字段(如客户年龄、地区),可采用均值、中位数、众数填充,或利用同类产品的均值插补。若缺失比例超过30%,则该字段可考虑舍弃或标记为“未知”类别。
三、异常值检测:识别真实与噪声
订单数量、单价、总价等数值型变量可能存在异常值。可采用箱线图(IQR法)或Z-score方法检测。例如,订单数量超过Q3+1.5IQR或低于Q1-1.5IQR的点视为异常,需结合业务判断——若是促销导致的真实大单,应保留;若是录入错误,则修正或删除。时间序列中的突变点可用滚动统计或STL分解识别。
四、特征工程:从原始数据中提炼预测信号
需求预测的核心是构造能反映时间趋势、季节性与产品关联的特征。常见操作包括:
- 时间特征:提取年、月、周、日、季度、是否节假日、是否周末等。
- 滞后特征:创建滞后1期、7期、30期的订单量,捕捉自相关性。
- 滑动窗口特征:计算3日、7日、30日的移动平均与移动标准差,平滑短期波动。
- 产品特征:产品类别、价格区间、生命周期阶段等独热编码或标签编码。
- 交互特征:如前一周订单量与促销标志的乘积。
需注意避免数据泄露——特征计算仅使用预测时点之前的信息。
五、数据整合:构建分析宽表
若订单数据分表存储(如订单表、产品表、客户表),需通过主键进行多表关联。以订单ID和产品ID为纽带,左连接订单与产品信息,补充产品类别、成本等;再关联客户表获取地区、渠道等维度。最终形成一张以“订单日期+产品ID”为粒度的宽表,每行包含历史需求及所有特征。为应对产品种类多、订单稀疏的问题,可聚合到周或月级别,并过滤掉销量极低的长尾产品。
六、数据划分:训练集与测试集
对于时间序列预测,不能随机划分。通常将最后一段时间(如最后3个月)作为测试集,其余为训练集。若需交叉验证,可采用时间序列的滚动窗口或扩张窗口方式。
数据处理是产品订单需求预测中最耗时但最关键的一步。通过系统化的清洗、缺失值处理、异常值检测、特征工程与整合,不仅能提升模型精度,还能增强对业务规律的理解。在泰迪杯B题第二大问中,扎实的数据处理将为后续的预测建模奠定坚实基础。